Comment la collection a été préparée pour la recherche.
Cette page décrit les choix techniques derrière MTL Archives, depuis les jeux de données municipaux jusqu’aux interfaces de recherche, de consultation visuelle et de travail éditorial.
Les métriques de cette page proviennent de rapports et d’artefacts datés. Elles décrivent des passes précises, pas une promesse générale de rendement.
Une collection publique, plusieurs couches de travail.
MTL Archives a commencé avec des jeux de données photographiques ouverts de la Ville de Montréal. Les images étaient accessibles, mais les notices, les fichiers et les identifiants n’étaient pas encore une base pratique pour la recherche.
Le travail a relié les notices aux fichiers, conservé les références sources, ajouté des informations dérivées dans des champs distincts, puis indexé les textes et les images pour plusieurs modes de recherche.
Le matériau de départ était déjà numérisé. Il n’était pas encore homogène.
Les manifestes inspectés contiennent des fichiers JPG, TIFF et quelques PDF, des noms, descriptions, dates, crédits, cotes et URL sources. Les champs ne sont pas remplis de façon uniforme. Certains titres ressemblent à des codes de fichier et plusieurs enregistrements renvoient à des images qui apparaissent dans plus d’un jeu de données.
Jeux de données photographiques et photothèque aérienne de la Ville de Montréal
7 945 JPG, 6 875 TIFF et 2 PDF dans le manifeste de travail
Nom, description, date, crédit, cote, URL source, correspondance portail
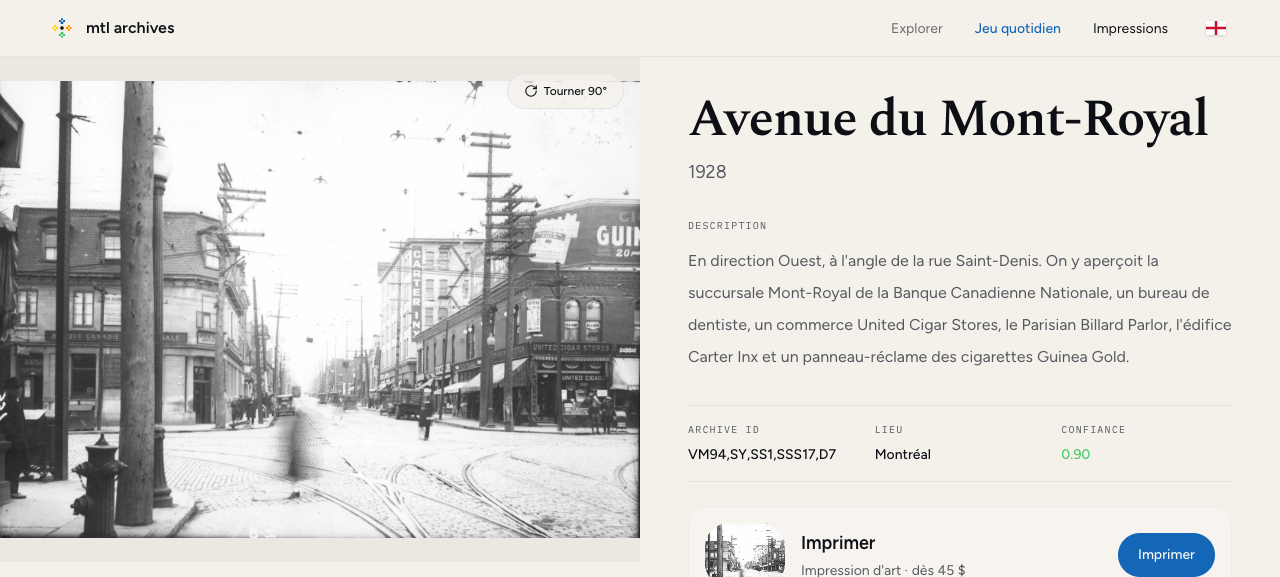
mtl_archives_metadata_0.json
Rue Saint-Antoine
Décennie 1920
En direction Est, à l’angle de la rue Saint-David (aujourd’hui disparue). On y aperçoit l’Édifice de The Gazette Printing Co ainsi que des panneaux-réclames de Magic Baking Powder et JJ Joubert Limitée.
VM94,SY,SS1,SSS17,D1
Archives de la Ville de Montréal
depot.ville.montreal.qc.ca/phototheque-archives/jpeg/VM94-Z2.jpg
Notice extraite de manifest_search_canonical.jsonl. Les accents et la ponctuation sont conservés ici pour montrer le contenu source, pas une nouvelle description.
Relier les notices, les fichiers et les identifiants.
L’ingestion télécharge les catalogues par lots, normalise les champs, associe les notices aux images et produit un manifeste canonique. Les doublons ne sont pas supprimés sans trace. Les identifiants sources restent attachés au résultat de production.
- 01
Ingestion
Télécharger les catalogues et les fichiers associés.
- 02
Normalisation
Uniformiser les champs et conserver les valeurs originales.
- 03
Association
Relier les notices, les images et les URL sources.
- 04
Dédoublonnage
Conserver une notice de production et documenter les doublons.
Total de la passe de réconciliation du 8 janvier 2026.
Notices uniques après dédoublonnage dans cette passe.
Différence entre les notices entrantes et les notices uniques de la passe.
La notice source et les observations dérivées ne sont pas le même objet.
Cote et identifiant original
Titre et date d’origine
Description et crédit
URL de l’institution
OCR lorsque du texte est présent
Légende générée, avec modèle et statut
Représentations textuelles et visuelles
Champs géographiques et taxonomiques disponibles
Le principe est simple : enrichir une notice sans faire passer une observation produite par machine pour une description archivistique. Les migrations et la réponse API conservent les champs de provenance de la légende, du modèle et du statut.
Une passe complète, avec ses erreurs visibles.
Le rapport de la passe VLM de mai 2026 contient 14 822 lignes d’entrée. 14 706 ont reçu une légende. 14 627 sorties respectaient la structure attendue. Les 79 sorties non valides et les 116 erreurs d’image ou de modèle restent comptées séparément.
99,2 % des lignes de cette passe enregistrée.
98,7 %. La validité de structure ne prouve pas la justesse historique.
Estimation issue d’une passe récupérée sur GPU A10, pas une mesure de facturation.
Le rapport reconstruit les 12 100 premières lignes à partir de lots sauvegardés, puis reprend les 2 722 restantes. Il n’existe pas de coût historique complet par notice dans les artefacts conservés.
Les index font le lien entre la préparation et l’interface.
La préparation est exécutée hors de l’interface publique. Le Worker reçoit la requête, interroge la branche disponible, hydrate les identifiants avec les notices de la base, puis renvoie les résultats avec leur provenance de récupération.
- 01
Notices sources
identifiants, titres, descriptions, crédits
- 02
Corpus normalisé
manifestes liés et dédoublonnés
- 03
Représentations
texte enrichi et vecteurs d’images
- 04
Index
recherche de texte, recherche sémantique, similarité visuelle
- 05
Interfaces
recherche publique, consultation, explorateur, outils éditoriaux
Pour les cotes, titres et champs exacts.
Pour rapprocher une requête textuelle des champs indexés.
Pour rapprocher une image des vecteurs CLIP enregistrés.
Tester des formulations que les champs exacts n’expriment pas directement.
Ces requêtes ont renvoyé des résultats dans la recherche sémantique publique le 21 septembre 2026. Elles illustrent le comportement de récupération. Elles ne constituent pas des descriptions archivistiques des documents.
Chercher, examiner les sources et constituer une collection.
L’Explorateur en ligne propose une recherche sémantique et visuelle; sa carte 2D/3D affiche un instantané distinct de 14 715 points, et certains résultats peuvent rester dans la liste sans apparaître sur la carte. La vue réactive utilise des couleurs par date, une légende et une mise en évidence des décennies. On peut examiner les sources, copier des citations, enregistrer une collection localement, exporter en CSV ou JSON et inspecter 20 voisins de similarité de l’instantané. Le nombre affiché est distinct du corpus de production daté de 13 499 notices. Le modèle et la date de l’instantané sont inconnus, et la proximité ne prouve ni une relation géographique ni un sujet historique commun.
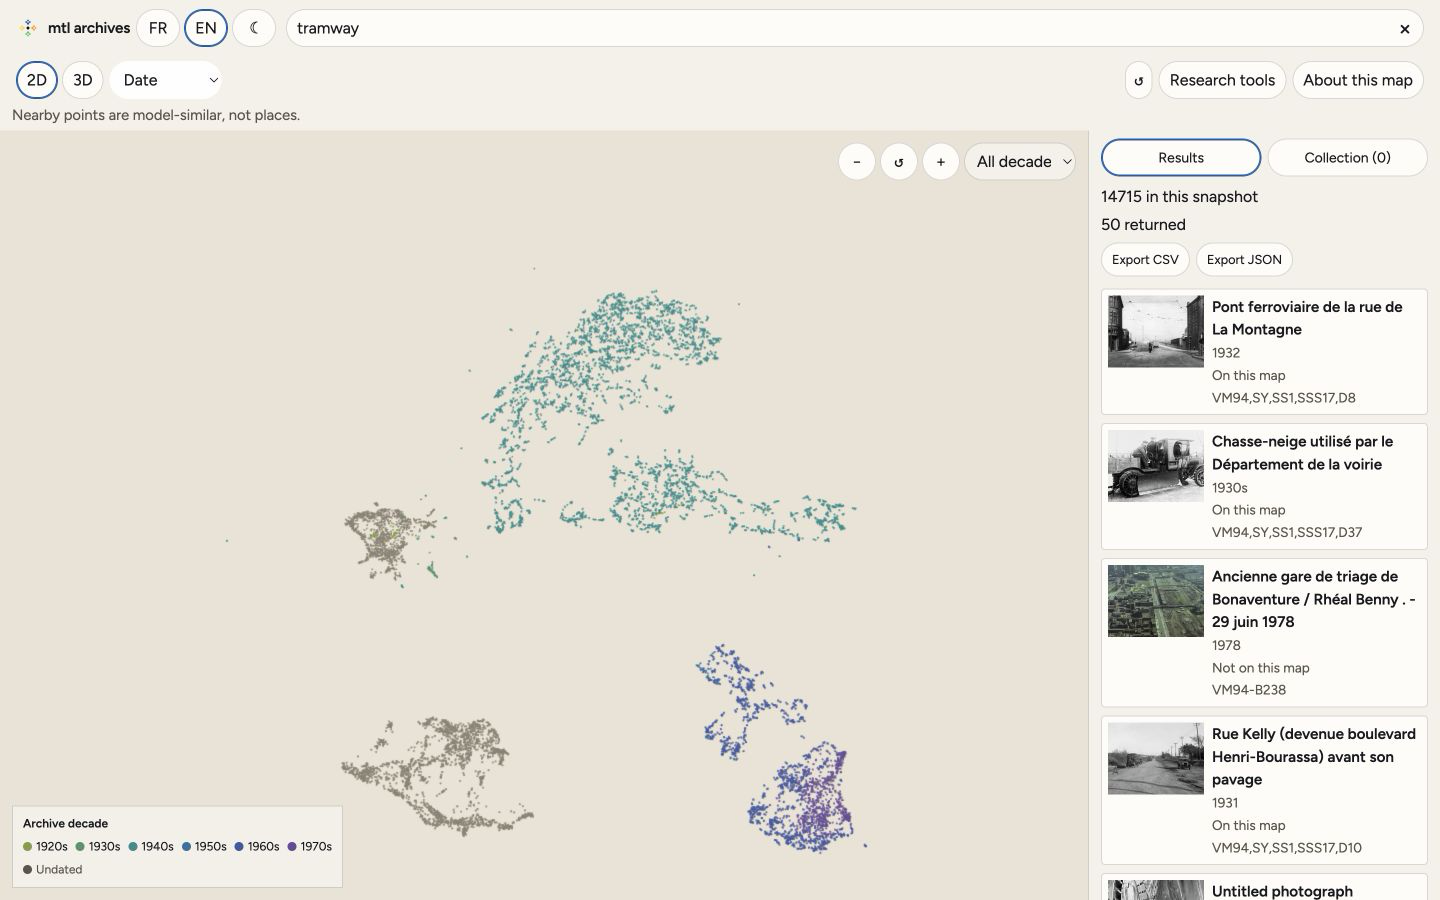
Espace Explorer en thème clair : requête, carte 2D colorée par date avec légende et liste de résultats avec titres et références.
Le pipeline alimente des outils utilisés par des personnes.
Le travail ne s’arrête pas à l’index. Les mêmes identifiants et fichiers servent à plusieurs interfaces, chacune avec un objectif différent.
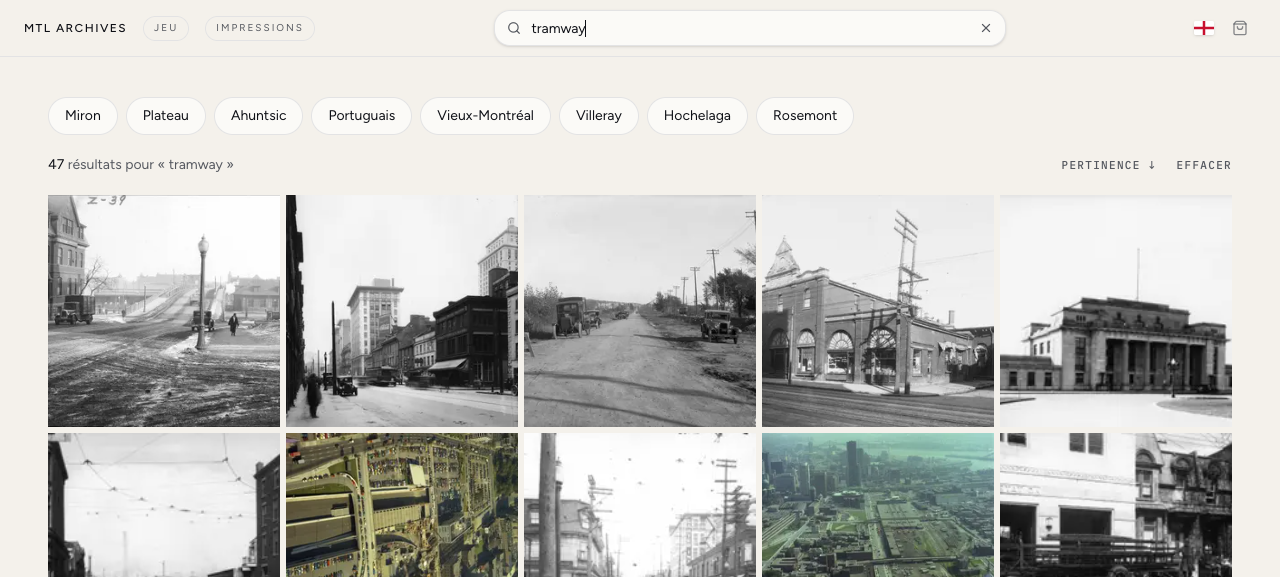
Requêtes textuelles, résultats, notices et liens vers la source.
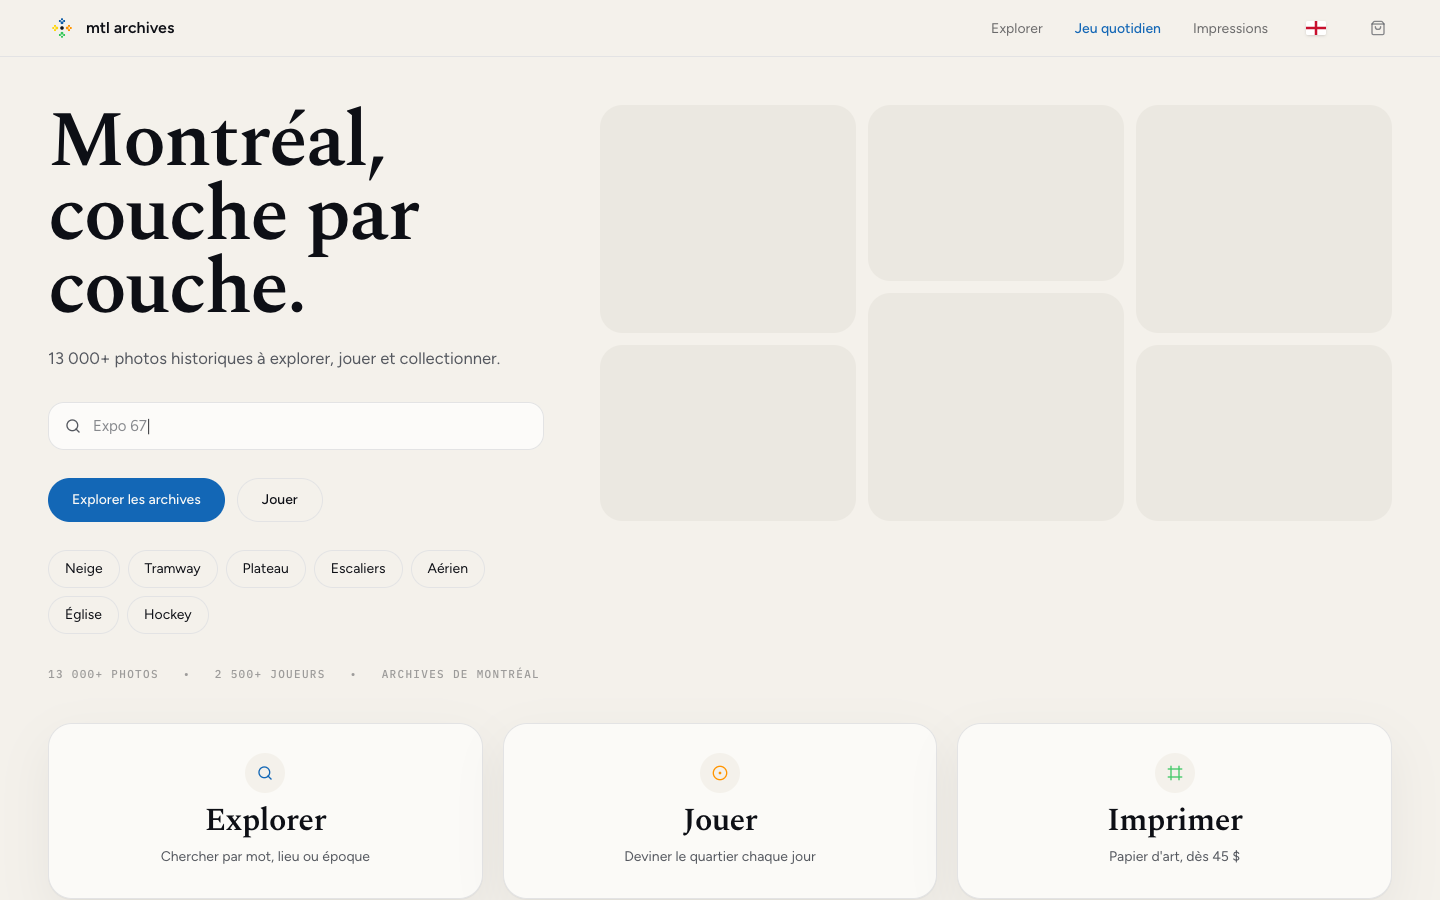
Navigation, recherche, jeu quotidien et commandes d’impression.
Recherche sémantique et visuelle, vue 2D/3D, détails de source, collections locales et export CSV/JSON.
Ce qui est conservé, ce qui est ajouté, ce qui reste à vérifier.
Les identifiants originaux, les crédits, les cotes et les URL sources restent attachés aux notices. Les légendes générées ont leur source, leur modèle et leur statut. Les procédures de réparation et de restauration sont documentées. Les enrichissements de MTL Archives ne doivent pas être décrits comme approuvés par des conservateurs.
Identifiants, titres, dates, descriptions, crédits, cotes et URL sources.
OCR, légendes, représentations vectorielles, taxonomie et coordonnées lorsque disponibles.
Statut de légende, modèle utilisé, source de génération et révisions documentées.
Une interface peut ajouter une revue, une correction, une approbation ou un rejet avant réutilisation.
Ce que les artefacts ne permettent pas encore de mesurer.
- 01
Coût historique par notice ou par lot, faute d’export de facturation conservé.
- 02
Latence de production p50 et p95, faute de série temporelle représentative.
- 03
Taux d’acceptation, de correction ou de temps de revue, faute d’événements de revue complets.
- 04
Temps de recherche économisé, faute d’étude contrôlée.
- 05
Exactitude historique de toutes les légendes, faute de validation humaine exhaustive.
- 06
Couverture géographique actuelle, car les artefacts de géocodage disponibles sont datés.
Le schéma peut changer. Les questions restent concrètes.
Une autre institution aura d’autres formats, droits, identifiants, règles de revue et besoins de recherche. Le travail réutilisable consiste à réconcilier la source, préserver son autorité, ajouter des couches dérivées, évaluer la recherche, indexer les résultats et relier ces données à des outils réellement utilisables.
[ Parler d’une collection]